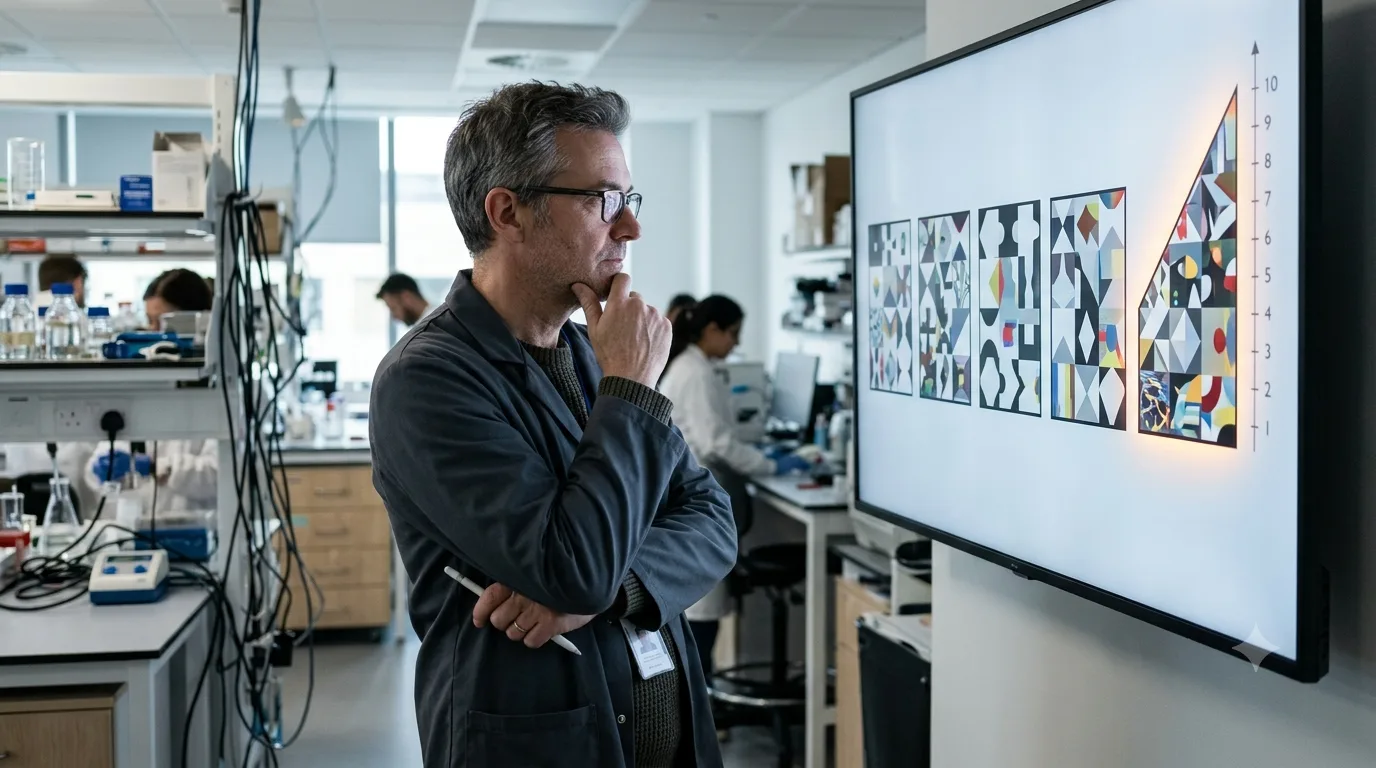
Test tvorí séria obrázkových úloh. Pri každej treba rozpoznať pravidlo vo vzore a vybrať chýbajúci obrazec. TrackingAI používa rovnakú sadu otázok na priebežné porovnávanie modelov umelej inteligencie. Ak model zvládne všetkých 35 úloh, projekt mu podľa vlastného prepočtu pridelí 151 bodov. Na tejto hranici sa jeho stupnica končí: ďalšia správna odpoveď už v teste nie je k dispozícii.
Práve tu vzniká rozdiel medzi výrazným titulkom a tým, čo bolo skutočne namerané. Mensa Norway pri svojom verejnom online teste uvádza výsledky od 85 do 145 bodov. Zároveň upozorňuje, že ide o orientačný test, ktorý nenahrádza odborné vyšetrenie inteligencie ani oficiálne testovanie organizácie. Hodnota 151 pochádza z metodiky TrackingAI, nie z výsledkovej stupnice, ktorú pri online teste uvádza Mensa.
Porovnanie s ľuďmi komplikuje aj spôsob, akým modely úlohy riešia. Obrazové modely môžu dostať pôvodné zadanie ako obrázok. Modelom bez obrazového vstupu TrackingAI opisuje tvary a ich usporiadanie slovami. Takýto opis môže ovplyvniť náročnosť úlohy: časť práce, ktorú musí človek pri pohľade na obrázok urobiť sám, je už obsiahnutá v texte zadania. Výsledky preto vypovedajú o výkone modelov v podmienkach projektu, nie o absolvovaní ľudského IQ testu za rovnakých okolností.
Napriek týmto výhradám je zmena výkonu pozoruhodná. Autor TrackingAI Maxim Lott v roku 2024 zverejnil výsledky skúšok starších modelov. Model Claude 1 v nich vyriešil priemerne šesť z 35 otázok a Lott mu vlastným výpočtom priradil približne 64 bodov. Podľa jeho hodnotenia to bolo blízko úrovne náhodného tipovania. Neskoršie modely zvládali viac úloh a niektoré sa napokon dostali až na strop rebríčka. Číslo 64 však treba čítať s rovnakou opatrnosťou ako číslo 151: leží mimo rozsahu, ktorý uvádza Mensa, a vzniklo prepočtom autora projektu.
Ďalšou otázkou je, čo presne úspech na verejnom teste meria. Jeho zadania sú dostupné na internete, takže nemožno spoľahlivo vylúčiť, že sa s nimi niektoré modely stretli už počas tréningu. Správna odpoveď potom môže odrážať schopnosť riešiť nový problém, znalosť podobných príkladov alebo kombináciu oboch. TrackingAI preto používa aj samostatný test s nezverejnenými otázkami. Výsledky modelov sa medzi týmito dvoma testami líšia, čo ukazuje, prečo sa ich schopnosti nedajú vystihnúť jediným skóre.
Keď model vyrieši všetkých 35 otázok, test už nedokáže povedať, o koľko lepšie by si poradil než iný model s rovnakým výsledkom. Na posúdenie ďalšieho pokroku treba nové a náročnejšie úlohy, ideálne také, ku ktorým modely počas tréningu nemali prístup. Skóre 151 je teda správou o dosiahnutí hranice jedného hodnotenia. Na otázku, aká „inteligentná“ je AI v širšom zmysle, samo osebe odpoveď nedáva.